1. The Limits of Keyword Search in Enterprise Repositories
When engineers, paralegals, or compliance officers search internal wikis (such as Confluence, SharePoint, or internal Git repositories), traditional lexical matching (e.g., BM25 or simple SQL LIKE queries) fails whenever the user's vocabulary diverges from the author's phrasing. For example, a search for "leave entitlement following childbirth" will miss policy documents explicitly entitled "Parental Bonding Absence Protocol."
OpenAI's third-generation embedding models—text-embedding-3-small and text-embedding-3-large—map text strings into high-dimensional geometric spaces where conceptual similarity translates directly into mathematical proximity (cosine similarity or dot product).
2. Model Comparison: text-embedding-3-small vs. text-embedding-3-large
Selecting the right embedding model impacts vector database memory consumption, index serialization speed, and retrieval precision:
| Model Specification | text-embedding-3-small | text-embedding-3-large |
|---|---|---|
| Native Dimensions | 1,536 dimensions | 3,072 dimensions |
| Dimension Truncation Support | Yes (down to 512 without retraining) | Yes (down to 1,024 or 256) |
| Relative Cost Profile | Ultra-economical for high volume | Premium accuracy tier |
| Primary Enterprise Use Case | High-throughput doc classification & search | Nuanced legal, medical & regulatory retrieval |
| Maximum Context Tokens | 8,191 tokens per chunk | 8,191 tokens per chunk |
3. Flexible Dimension Shortening (Matryoshka Representation)
A key technical innovation in OpenAI's text-embedding-3 generation is Matryoshka representation learning. This technique allows enterprises to truncate vector outputs (e.g., slicing a 3,072-dimension vector down to 1,024 dimensions) using the dimensions API parameter without catastrophic loss of retrieval quality.
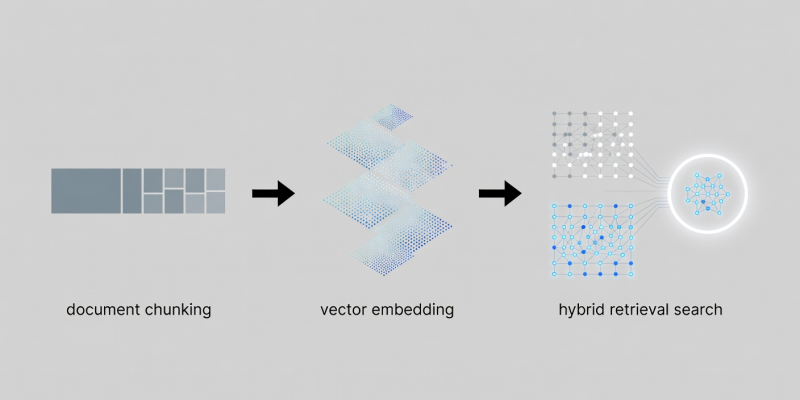
4. Chunking Strategy & Hybrid Search Best Practices
Submitting entire 50-page manuals as single embedding vectors dilutes semantic density. Enterprise retrieval architectures require disciplined chunking protocols:
- Chunk Size: Target 300 to 500 tokens per chunk with an overlap of 50 tokens to maintain continuity at sentence boundaries.
- Metadata Injection: Prepend document title, section headers, and last-modified dates directly to each chunk payload before embedding.
- Hybrid Retrieval: Combine dense vector similarity (cosine) with sparse BM25 keyword matching via Reciprocal Rank Fusion (RRF) to ensure specific alphanumeric identifiers (like error codes or SKU numbers) are never overlooked.
5. Pros and Cons of Vector-Based Enterprise Knowledge Retrieval
Architectural Strengths
- Multilingual semantic search: English queries can retrieve relevant Spanish or German documents.
- Reduces hallucination by constraining LLM synthesis strictly to retrieved reference passages.
- Granular access control: vector entries can be filtered by role-based permissions (RBAC) at query time.
Engineering Pitfalls
- Chunk boundary truncation can sever contextual dependencies between paragraphs.
- High-frequency document updates require continuous re-indexing pipelines.
- Pure dense search struggles with exact keyword SKU matching without hybrid BM25 support.